Introduzione
Nel mondo scientifico la matematica è il pilastro su cui poggia ogni nostra dimostrazione. Ultimamente, anche contro ogni buon senso, quando non si è in grado di controargomentare qualcosa si ricorre alla frase: «Cita le tue fonti».
Dietro c’è una pia illusione: se un articolo è stato pubblicato, dei tuoi pari l’hanno letto e gli hanno fatto le pulci. Deve essere quindi scevro di ogni possibile errore logico o materiale.
Purtroppo non è così: vengono pubblicati spesso articoli che contengono diversi errori, poi propagati senza che nessuno si ponga il benché minimo dubbio, tanto «l’avrebbe già dovuto fare qualcuno». In questo articolo vi farò toccare con mano uno dei tanti casi che mi sono capitati sotto il naso.
I prodromi
Tra la fine del 2017 e l’inizio del 2018 stavo cominciando a studiare come intercettare i soggetti prediabetici. Volevo vedere se esistesse una tecnica numerica che permettesse di identificare le forme delle curve da carico; all’epoca volevo anche capire se si potesse sfruttare il peptide C per trarne qualche informazione. Così sono andato a vedere il sito della Società Italiana di Diabetologia (ho pensato, nella mia ingenuità: se non lo sanno loro…) e ho trovato questa pagina: https://www.siditalia.it/clinica/formule-e-calcolatori/whoshcp
Mi sono scaricato il lavoro di riferimento (Tura A, Morbiducci U, Sbrignadello S, Winhofer Y, Pacini G, Kautzky-Willer A. Shape of glucose, insulin, C-peptide curves during a 3-h oral glucose tolerance test: any relationship with the degree of glucose tolerance? Am J Physiol Regul Integr Comp Physiol. 2011;300:R941-8). Se volete, potete scaricarlo anche voi da questo link e leggerlo.
Gli autori hanno analizzato 592 curve da carico di 3 ore, quasi tutte di donne con pregresso diabete gestazionale. Le hanno poi divise in 4 gruppi secondo la forma della curva glicemica: monofasica (un picco), bifasica, trifasica (due picchi) e a 4/5 fasi (tre picchi).
Infine hanno proposto un indice di forma, il WHOSH, che si basa sul calcolo della media dei valori assoluti delle derivate seconde. Può sembrare una cosa difficile; in realtà è abbastanza semplice e anche uno studente delle scuole medie non dovrebbe avere grosse difficoltà a farlo con carta e penna: si tratta semplicemente di qualche sottrazione e divisione.
Il metodo si può applicare alla curva glicemica, a quella insulinemica e a quella del peptide C. C’è anche un foglio Excel (che loro hanno protetto dalla modifica… illusi…) per calcolare il tutto. Poiché sono molto interessato all’analisi delle curve che otteniamo dal carico orale di glucosio, un nuovo modello matematico è qualcosa da leggere con molta attenzione.
Matematica e calcolo differenziale
Nel file Excel c’è un esempio e io cerco di replicarlo ma… il risultato è diverso. Di poco ma è diverso. Sproteggo il file in 5 secondi, leggo le celle e, ovviamente, c’è un errore di calcolo nella derivata seconda.
La derivata prima
Ma procediamo con calma e cerchiamo di capire di cosa stiamo parlando.
Quando abbiamo qualcosa che varia nel tempo, la derivata prima rappresenta la velocità con cui cambia mentre la derivata seconda ne rappresenta l’accelerazione. Nel file Excel scaricato troviamo i seguenti dati:
| Punto | Tempo (min) | Peptide C (pmol/L) |
|---|---|---|
| 1 | 0 | 1017.825 |
| 2 | 10 | 1913.180 |
| 3 | 20 | 2204.460 |
| 4 | 30 | 2803.570 |
| 5 | 60 | 3641.000 |
| 6 | 90 | 5064.300 |
| 7 | 120 | 4269.900 |
| 8 | 150 | 4303.000 |
| 9 | 180 | 4071.300 |
Per calcolare la velocità con cui cambia il peptide C devo calcolare la differenza di quantità e di tempo tra due punti consecutivi e poi farne il rapporto, per esempio: (1913.180−1017.825)/(10−0) = 89.5355
| Punto | Tempo (t) | Peptide C (x) | Δx | Δt | v=Δx/Δt |
|---|---|---|---|---|---|
| 1 | 0 | 1017.825 | |||
| 2 | 10 | 1913.180 | 895.355 | 10 | 89.5355 |
| 3 | 20 | 2204.460 | 291.280 | 10 | 29.1280 |
| 4 | 30 | 2803.570 | 599.110 | 10 | 59.9110 |
| 5 | 60 | 3641.000 | 837.430 | 30 | 27.9143 |
| 6 | 90 | 5064.300 | 1423.300 | 30 | 47.4433 |
| 7 | 120 | 4269.900 | -794.400 | 30 | -26.4800 |
| 8 | 150 | 4303.000 | 33.100 | 30 | 1.1033 |
| 9 | 180 | 4071.300 | -231.700 | 30 | -7.7233 |
Come si legge? Per passare dal punto 1 al punto 2 il peptide C è aumentato di 895.355 pmol/L in 10 minuti: la velocità è quindi 89.5355 pmol/L al minuto.
La derivata seconda
Analogamente, per calcolare l’accelerazione devo calcolare la differenza di velocità e di tempo tra due intervalli consecutivi e poi farne il rapporto. C’è però un dettaglio che fa tutta la differenza: ogni velocità non si riferisce a un istante ma a un intervallo e va collocata nel suo punto medio. Il Δt della derivata seconda è quindi la distanza tra i punti medi di due intervalli consecutivi. Quando i due intervalli sono uguali coincide con la loro durata (10 o 30 minuti); nel passaggio dagli intervalli di 10 minuti a quelli di 30 vale (10+30)/2 = 20 minuti.
ai = 2·[(xi+1−xi)/h2 − (xi−xi−1)/h1] / (h1+h2)
(h1 e h2 = intervalli di tempo prima e dopo il punto i)
È la matematica standard della derivata seconda numerica a tre punti per tempi non equidistanti, cioè la derivata seconda esatta della parabola che passa per tre punti consecutivi: nessun denominatore scelto a occhio, solo i tempi di campionamento effettivi.
| Tempo del punto (min) | v prima | v dopo | Δv | Δt (tra i punti medi) | a=Δv/Δt |
|---|---|---|---|---|---|
| 10 | 89.5355 | 29.1280 | -60.4075 | 10 | -6.0408 |
| 20 | 29.1280 | 59.9110 | 30.7830 | 10 | 3.0783 |
| 30 | 59.9110 | 27.9143 | -31.9967 | 20 | -1.5998 |
| 60 | 27.9143 | 47.4433 | 19.5290 | 30 | 0.6510 |
| 90 | 47.4433 | -26.4800 | -73.9233 | 30 | -2.4641 |
| 120 | -26.4800 | 1.1033 | 27.5833 | 30 | 0.9194 |
| 150 | 1.1033 | -7.7233 | -8.8267 | 30 | -0.2942 |
Quindi, per esempio, nel punto a 10 minuti la velocità diminuisce con un’accelerazione di −6.0408 pmol/L al minuto2.
Cosa scrivono gli autori e cosa calcola il foglio Excel
Nel lavoro la formula è dichiarata, nero su bianco:
Δ2Gi/Δti2 = (ΔGi+1/Δti+1 − ΔGi/Δti) / Δti
Gli autori dividono sempre per il primo dei due intervalli. Finché gli intervalli sono uguali il risultato coincide con la derivata seconda; nel passaggio da 10 a 30 minuti no. Nel punto a 30 minuti la loro formula dà −3.1997 invece di −1.5998: il doppio.
E il foglio Excel? Non applica né la derivata seconda né la formula del lavoro: nei punti a 30 e a 90 minuti divide per 25 e per 15 minuti, numeri che non corrispondono a nessun intervallo della curva.
| Tempo del punto (min) | Derivata seconda | Formula del lavoro | Foglio Excel |
|---|---|---|---|
| 10 | -6.0408 | -6.0408 | -6.0408 |
| 20 | 3.0783 | 3.0783 | 3.0783 |
| 30 | -1.5998 | -3.1997 | -1.2799 |
| 60 | 0.6510 | 0.6510 | 0.6510 |
| 90 | -2.4641 | -2.4641 | -4.9282 |
| 120 | 0.9194 | 0.9194 | 0.9194 |
| 150 | -0.2942 | -0.2942 | -0.2942 |
| Media del valore assoluto | 2.1497 | 2.3782 | 2.4560 |
Le derivate prime coincidono tutte; le derivate seconde danno tre risultati diversi. Rispetto alla derivata seconda vera la formula del lavoro gonfia l’indice dell’11% circa e il foglio Excel del 14% circa. La matematica non è un’opinione: se dichiari di usare la derivata seconda la devi calcolare; se applichi un altro criterio lo devi dire e non puoi chiamarlo derivata seconda. Il colmo è che gli autori scrivono testualmente che «a simple spreadsheet is adequate to implement the index formula»: il foglio c’è, la formula giusta no.
Un indice che dipende dal campione
C’è un ultimo passaggio nella definizione dell’indice: il valore di ogni soggetto viene diviso per la media di tutto il campione. WHOSH = 1 significa quindi «uguale alla media di queste 592 donne» e nient’altro. Nel lavoro il valore di quella media non è riportato: chi calcola l’indice su un nuovo paziente, per che cosa lo divide?
La matematica del rumore analitico
La derivata seconda calcolata su pochi punti amplifica l’errore analitico delle singole misure: è una stima della curvatura della serie misurata, non della curva biologica.
E qui i numeri sono impietosi. Gli autori dichiarano per il peptide C un coefficiente di variazione analitico inferiore al 5%. Se applico un errore casuale e indipendente del 5% ai punti dell’esempio, il solo rumore produce da sé un indice di circa 0.97, contro il 2.15 della curva: quasi la metà.
Ripetendo la misura della stessa curva l’indice oscillerebbe con un coefficiente di variazione del 31% circa; con un errore del 3% siamo ancora al 22%. Gli autori riportano solo il coefficiente di variazione tra serie diverse: se i campioni di una stessa curva sono dosati nella stessa seduta conta quello entro la serie, di solito più basso. Ma non è dichiarato.
Lo stesso problema riguarda la classificazione delle curve. Gli autori considerano significativa una variazione tra due prelievi consecutivi del 2% per la glicemia e del 5% per insulina e peptide C, cioè pari al coefficiente di variazione dei metodi. Ma la minima differenza significativa tra due misure è circa 2.77 volte il coefficiente di variazione: il 5.5% per la glicemia e il 14% per insulina e peptide C. Molti dei «picchi» che definiscono i gruppi possono essere quindi solo rumore (e anche qui il coefficiente di variazione entro la serie non è dichiarato).
Gli autori hanno provato anche la soglia del 5% sulla glicemia e i gruppi cambiano parecchio: i monofasici passano da 262 a 309, i trifasici da 201 a 165, le curve a 4/5 fasi da 37 a 26. Le conclusioni però, scrivono, non cambiano: «not shown».
Se il buongiorno si vede dal mattino, ho pensato che fosse meglio andare a leggere il resto con attenzione.
Matematica e statistica: il tallone di Achille
Come d’abitudine vado dritto ai numeri: ho avuto l’ennesima conferma che no, medici e numeri non vanno molto d’accordo.

La distribuzione di Gauss: la media e la deviazione standard
Quando si misura qualcosa molte volte può succedere che le misure si distribuiscano in maniera gaussiana (la curva a campana di Gauss).

La distribuzione può essere riassunta con soli 2 parametri:
- la media (il valore centrale della campana, in verde, μ nella formula), in corrispondenza della quale la funzione di Gauss raggiunge il suo massimo;
- la deviazione standard (l’ampiezza della campana, il tratto che congiunge un punto rosso con la linea verde, σ nella formula). I due punti rossi, media±deviazione standard, sono i «punti di flesso» della curva di Gauss: i punti in cui la curva da concava diventa convessa (o viceversa).
Incominciamo a vedere il primo errore di questa tabella: i dati sono riportati come media ed errore standard della media. L’errore standard dice con quale precisione è stata stimata la media, non quanto sono dispersi i valori dei soggetti. Per descrivere un gruppo a noi serve la deviazione standard.
Fortunatamente esiste una precisa relazione matematica tra la deviazione standard e l’errore standard della media: l’errore diminuisce con la radice quadrata del numero delle misure effettuate.
ES=DS/RADQ(N)
(ES=errore standard; DS=deviazione standard; RADQ=radice quadrata; N=numero di misure)
Prendiamo la glicemia basale del gruppo monofasico: media 5.43 mmol/L = 97.8 mg/dL, errore standard 0.07 mmol/L, 262 soggetti. La deviazione standard sarà quindi DS = 0.07·RADQ(262) = 1.13 mmol/L = 20.42 mg/dL (qui e in tutto l’articolo uso il fattore di conversione 1 mmol/L = 18.018 mg/dL).
Matematica della distribuzione di Gauss e popolazione contenuta
Quando riassumo una distribuzione con media e deviazione standard sto dicendo una cosa molto precisa: se la distribuzione è gaussiana, il 99% delle osservazioni ricade nell’intervallo media±2.58 deviazioni standard.

Torniamo alla glicemia basale del gruppo monofasico: 5.43 mmol/L = 97.8378 mg/dL (media). La glicemia dei 262 soggetti analizzati dovrebbe quindi variare tra:
- max = 97.8378+2.58·20.4153 = 150.5093 mg/dL
- min = 97.8378−2.58·20.4153 = 45.1663 mg/dL
Il limite superiore mi sta bene: nel gruppo monofasico ci sono anche 36 soggetti con diabete mellito. Il limite inferiore, invece, non regge proprio: stiamo scherzando??? Sotto i 54 mg/dL si parla di ipoglicemia clinicamente significativa. Una gaussiana con questa media e questa deviazione standard prevede che circa 4 soggetti su 262 abbiano una glicemia a digiuno sotto quella soglia: in una coorte sottoposta a OGTT è semplicemente implausibile.
Del resto la glicemia è limitata in basso per ragioni fisiologiche ed è libera di salire verso l’alto: una distribuzione troncata a sinistra e scodata a destra non è gaussiana per definizione. Queste misure NON possono essere descritte con una gaussiana e riassumerle con media e deviazione standard è fuorviante.
Matematica e statistica: test di verifica delle ipotesi
Se la matematica è la bestia nera, la statistica è il demonio in persona.
Le differenze tra i gruppi sono state studiate mediante analisi della varianza (ANOVA, ANalysis Of VAriance). Gli autori dichiarano di aver verificato la normalità delle variabili e di aver usato i logaritmi per quelle non normali. Bene; ma non riportano l’esito della verifica né se il logaritmo abbia davvero reso normali le distribuzioni; i risultati sono poi presentati come media±errore standard sulla scala originale.
Dell’omogeneità delle varianze non si parla e le deviazioni standard della glicemia basale vanno da 5.5 a 20.4 mg/dL: le varianze differiscono di quasi 14 volte. L’ANOVA regge a deviazioni moderate ma queste non lo sono: andava corretta (per esempio con l’ANOVA di Welch) oppure sostituita da un test non parametrico come il Kruskal-Wallis, con confronti a coppie di Mann-Whitney-Wilcoxon.
E c’è di peggio. La Tabella 1 del lavoro riporta 23 variabili, ognuna con 6 confronti a coppie tra i gruppi: circa 140 test, senza alcuna indicazione del metodo usato né della correzione per i confronti multipli. A P<0.05, anche se non ci fosse nessuna differenza vera, ci aspetteremmo circa 7 risultati «significativi» per puro caso.
Vi riporto i dati della glicemia basale dei 4 gruppi in mg/dL per comodità.
| Monofasica | Bifasica | Trifasica | 4/5 fasi | |
|---|---|---|---|---|
| Numerosità | 262 | 76 | 201 | 37 |
| Media | 97.8 | 91.2 | 88.8 | 84.5 |
| Deviazione standard | 20.4 | 14.1 | 10.2 | 5.5 |
| Errore standard | 1.26 | 1.62 | 0.72 | 0.90 |
Nel caso di specie, la domanda che si fa al test statistico è: questi soggetti divisi in 4 gruppi vengono in realtà dalla stessa popolazione? Il test risponde di no: se i 4 gruppi venissero davvero dalla stessa popolazione, differenze grandi come quelle osservate sarebbero talmente improbabili da far rigettare l’ipotesi.
Ma è ovvio! 97.8 e 91.2 sono due numeri differenti e gli errori standard (tra 0.7 e 1.6 mg/dL) sono molto più piccoli della differenza tra le medie.
Qui dovrebbe subentrare il cervello del ricercatore: il risultato è statisticamente significativo. Ma è anche clinicamente rilevante? Tra 97.8 e 84.5 mg/dL ci sono 13 mg/dL di differenza media; entrambi i valori stanno però pienamente nella norma. E una differenza tra le medie dei gruppi non dice ancora nulla sulla capacità di classificare il singolo paziente.
Quando le gaussiane si sovrappongono
E a questo punto passiamo all’indice WHOSH calcolato sulla glicemia.

Nel grafico avete la rappresentazione delle «gaussiane» dei 4 gruppi. Che il WHOSH glicemico aumenti con il numero di picchi lo ammettono gli autori stessi: «of course expected». E per forza: i gruppi sono definiti dalle oscillazioni della curva glicemica e l’indice misura le oscillazioni della stessa curva. È un ragionamento circolare. Non a caso gli autori scrivono che il WHOSH glicemico «must not be considered at all» per definire la tolleranza glucidica del singolo soggetto.
Proviamo a vedere se cambia qualcosa con la curva insulinemica.

Più o meno siamo nelle stesse condizioni di prima.
Terminiamo con il peptide C, che è l’indice su cui gli autori puntano tutto.

La situazione non poteva che essere la stessa. Ricavando le deviazioni standard dagli errori standard, il WHOSH del peptide C vale 0.93±0.65 nel gruppo monofasico e 1.35±0.85 in quello a 4/5 fasi: una dispersione pari al 60-70% della media. E anche qui la gaussiana non regge: con questi parametri prevederebbe valori negativi tra il 5% e l’8% dei soggetti per un indice che è, per costruzione, una media di valori assoluti.
Un surrogato della funzione beta-cellulare?
Gli autori concludono che il WHOSH del peptide C «can be a surrogate» della glucose sensitivity, il parametro di funzione beta-cellulare ricavato con il modello di Mari. Su quale base? Una regressione con R2 = 0.202, cioè una correlazione di 0.45: l’80% della variabilità dell’indice resta non spiegata dal parametro che dovrebbe sostituire.
Rispetto ai parametri dell’IVGTT va anche peggio: R2 = 0.221 con l’AIR e 0.155 con l’ACPR; la glucose sensitivity arriva a 0.363 e 0.408. E nell’analisi multivariata dei determinanti della glicemia media, quando c’è la glucose sensitivity, il WHOSH del peptide C non risulta nemmeno significativo. Essere ridondante non significa essere un surrogato: per dimostrarlo servirebbe un’analisi di concordanza con l’indice di riferimento, che nel lavoro non c’è.
E la curva ROC?
Gli autori scrivono che l’indice «may be applied in the clinical contest» e che è in grado di distinguere soggetti normotolleranti, con alterata glicemia e diabetici. I numeri? 1.07±0.61, 0.93±0.58 e 0.67±0.34 (deviazioni standard ricavate dagli errori standard). Per dire se un indice serve a classificare il singolo paziente serve una curva ROC, con l’area sotto la curva e la sensibilità e la specificità a una soglia dichiarata. Nel lavoro non c’è nessuna curva ROC, nessuna soglia, nessuna sensibilità né specificità: solo differenze tra le medie dei gruppi.
La curva ROC possiamo stimarla noi, con un po’ di matematica. Prendiamo per buone le gaussiane che gli autori stessi presuppongono quando riportano media±errore standard e usano l’ANOVA: dalle medie e dalle deviazioni standard si ricava l’area sotto la curva (AUC) con il modello binormale, AUC = Φ(|μ1−μ2|/√(σ12+σ22)). Un’AUC di 0.5 equivale al lancio di una moneta; tra 0.7 e 0.8 la capacità discriminante è accettabile, tra 0.8 e 0.9 eccellente, sopra 0.9 eccezionale.
Per confronto ho fatto lo stesso calcolo con la glucose sensitivity, l’indice che il WHOSH del peptide C dovrebbe sostituire.
| Confronto | WHOSH del peptide C | Glucose sensitivity |
|---|---|---|
| Normotolleranti contro alterata glicemia | 0.57 | 0.73 |
| Alterata glicemia contro diabetici | 0.65 | 0.84 |
| Normotolleranti contro diabetici | 0.72 | 0.91 |
| Normotolleranti con e senza pregresso diabete gestazionale | 0.60 | 0.60 |
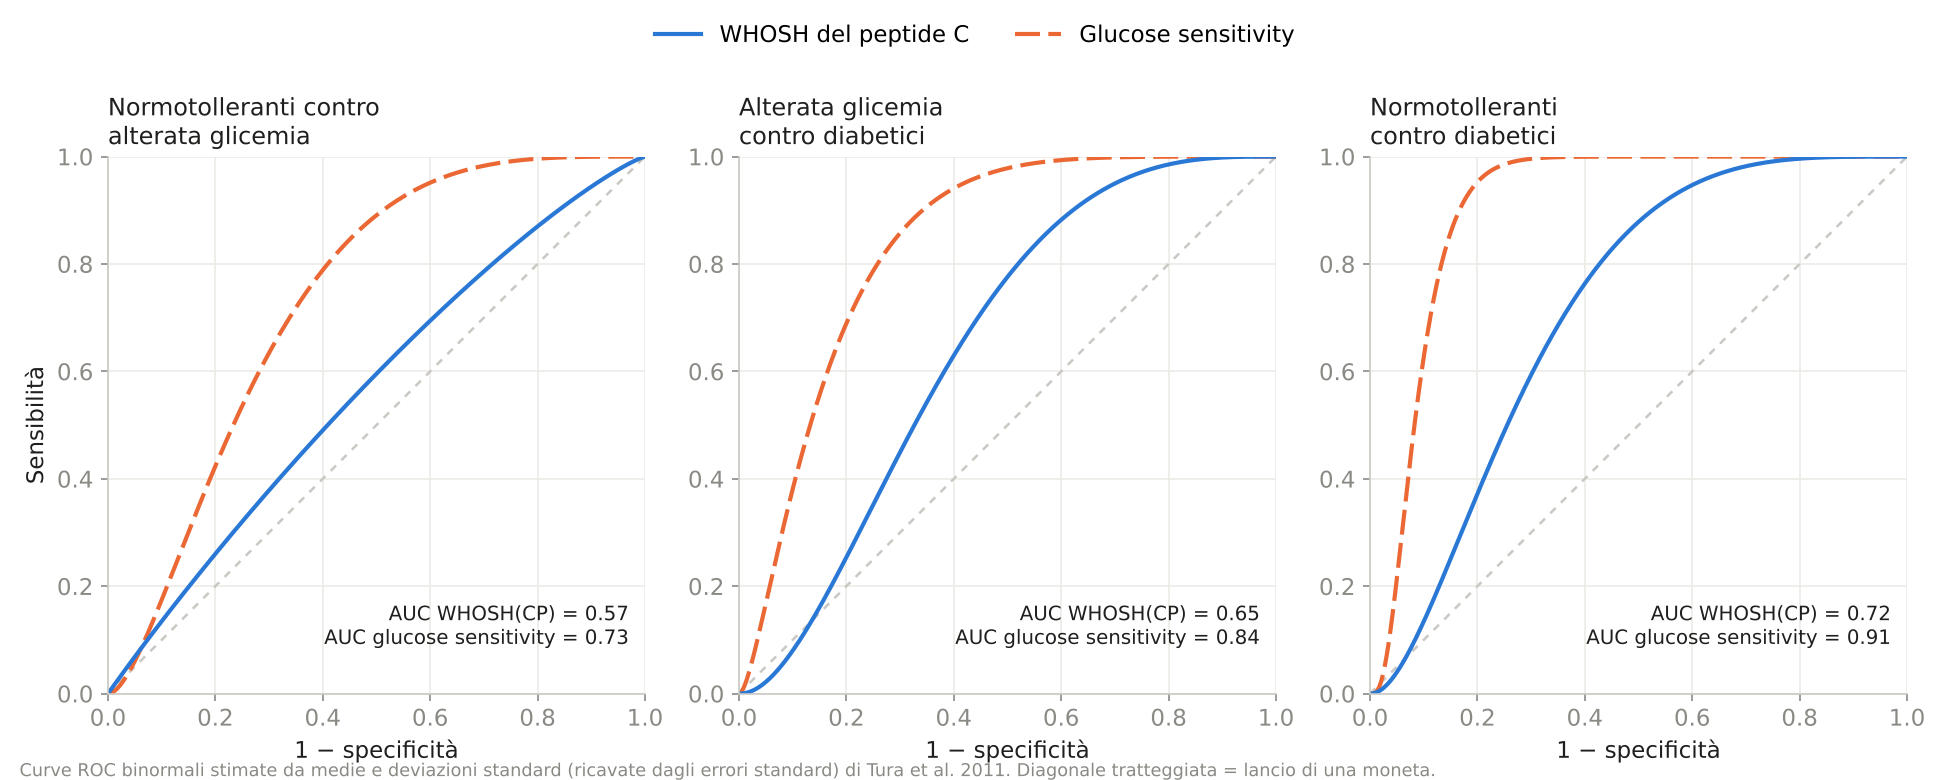
Secondo queste stime il WHOSH del peptide C distingue i normotolleranti dalle persone con alterata glicemia poco meglio di una moneta (0.57) e anche tra normotolleranti e diabetici si ferma a un appena accettabile 0.72, contro lo 0.91 dell’indice di riferimento. In nessun confronto fa meglio della glucose sensitivity: nel migliore dei casi la eguaglia.
Sono stime, non una ROC vera: le distribuzioni reali non sono gaussiane e con i dati individuali l’AUC potrebbe venire diversa in un senso o nell’altro. Se però venissero confermate avremmo un surrogato che perde informazione proprio dove servirebbe di più, cioè nel passaggio dalla normalità al prediabete. La ROC vera la possono fare solo gli autori, che hanno i dati: è il conto che avrebbero dovuto fare e pubblicare prima di proporre l’indice in clinica.
A questo si aggiungono le affermazioni appoggiate su dati non mostrati: la soglia del 5% che «non cambia» le conclusioni, la versione semplificata a 2 ore che conferma «molte proprietà» dell’indice, il confronto con l’indice insulinogenico, l’assenza di differenze tra maschi e femmine su un campione di 72 soggetti (P=0.09–0.4: l’assenza di prova non è prova di assenza). Infine la popolazione: solo donne, in gran parte con pregresso diabete gestazionale, con appena 47 diabetiche su 592. Gli autori lo riconoscono come limite ma ne propongono lo stesso l’uso clinico.
Conclusioni
Ricapitolando, bisogna distinguere tre affermazioni diverse, che richiedono prove diverse. Che la formula sia sbagliata lo dimostra la matematica: chiamano derivata seconda una cosa che non lo è e il foglio Excel non applica nemmeno quella.
Che l’indice sia poco robusto è fortemente indicato: dipende da una media di normalizzazione che non viene pubblicata, con l’imprecisione analitica dichiarata rischia di confondersi con il rumore e la statistica di gruppo è condotta senza correzioni.
Che l’indice sia clinicamente inutile, invece, con i soli dati pubblicati non si può dimostrare: potrebbe avere un valore descrittivo o fisiologico. Ma l’onere della prova spetta a chi ne propone l’uso clinico e nel lavoro quella prova non c’è: nessuna curva ROC, nessuna soglia, nessuna analisi di concordanza. E intanto il calcolatore sta sul sito di una società scientifica.
Non possiamo spegnere il cervello solo perché un articolo è stato pubblicato. Se conosciamo la matematica e le sue leggi possiamo sempre capire se c’è un errore da qualche parte. Non si può fare il lavoro di scienziato senza conoscere a fondo la matematica e le sue implicazioni. E se sei un medico, non hai scuse lo stesso.
Sullo stesso filo — la matematica che fa chiarezza dove le parole ingannano — leggi anche perché l’omeopatia non può funzionare.